1.适用场景
适用于交通、金融、政府、集团企业等大量无人值守网点 / 站点、业务入口分散的客户。该环境下多数目标无法部署 Agent、未开启 SNMP,无法采集指标,需平台主动探测判断可用性。2.为什么要建设探测
痛点:监控大屏全绿,业务已经断了
- 纳管不上: 装不了代理、开不了 SNMP 的对象只能登记待纳管,上百个网点逐个手工新建不现实。
- 发现太晚: 断网无人知晓,等用户报障时已滞后半个多小时;人工 ping 无法持续,判断不了单点故障还是线路故障。
- 分不清障: ICMP 通、专线对端设备正常,业务链路已断,故障影响面无法界定。
- 页面无感: 服务器指标正常,页面已打不开或返回错误页,只能由用户先发现。
3.探测最佳实践
核心设计思路: 先按「能不能装代理、要不要页面级判断」确定用哪类探测,再按网段或业务归入分组,让建完的对象在列表里可查可管。3.1 探测类型选型
选型依据是「这个对象能观测到什么」,与设备类型无关。多网点环境中用得最多的是 Ping、WEB、TCP 三类。
3.2 探测命名与分组规划
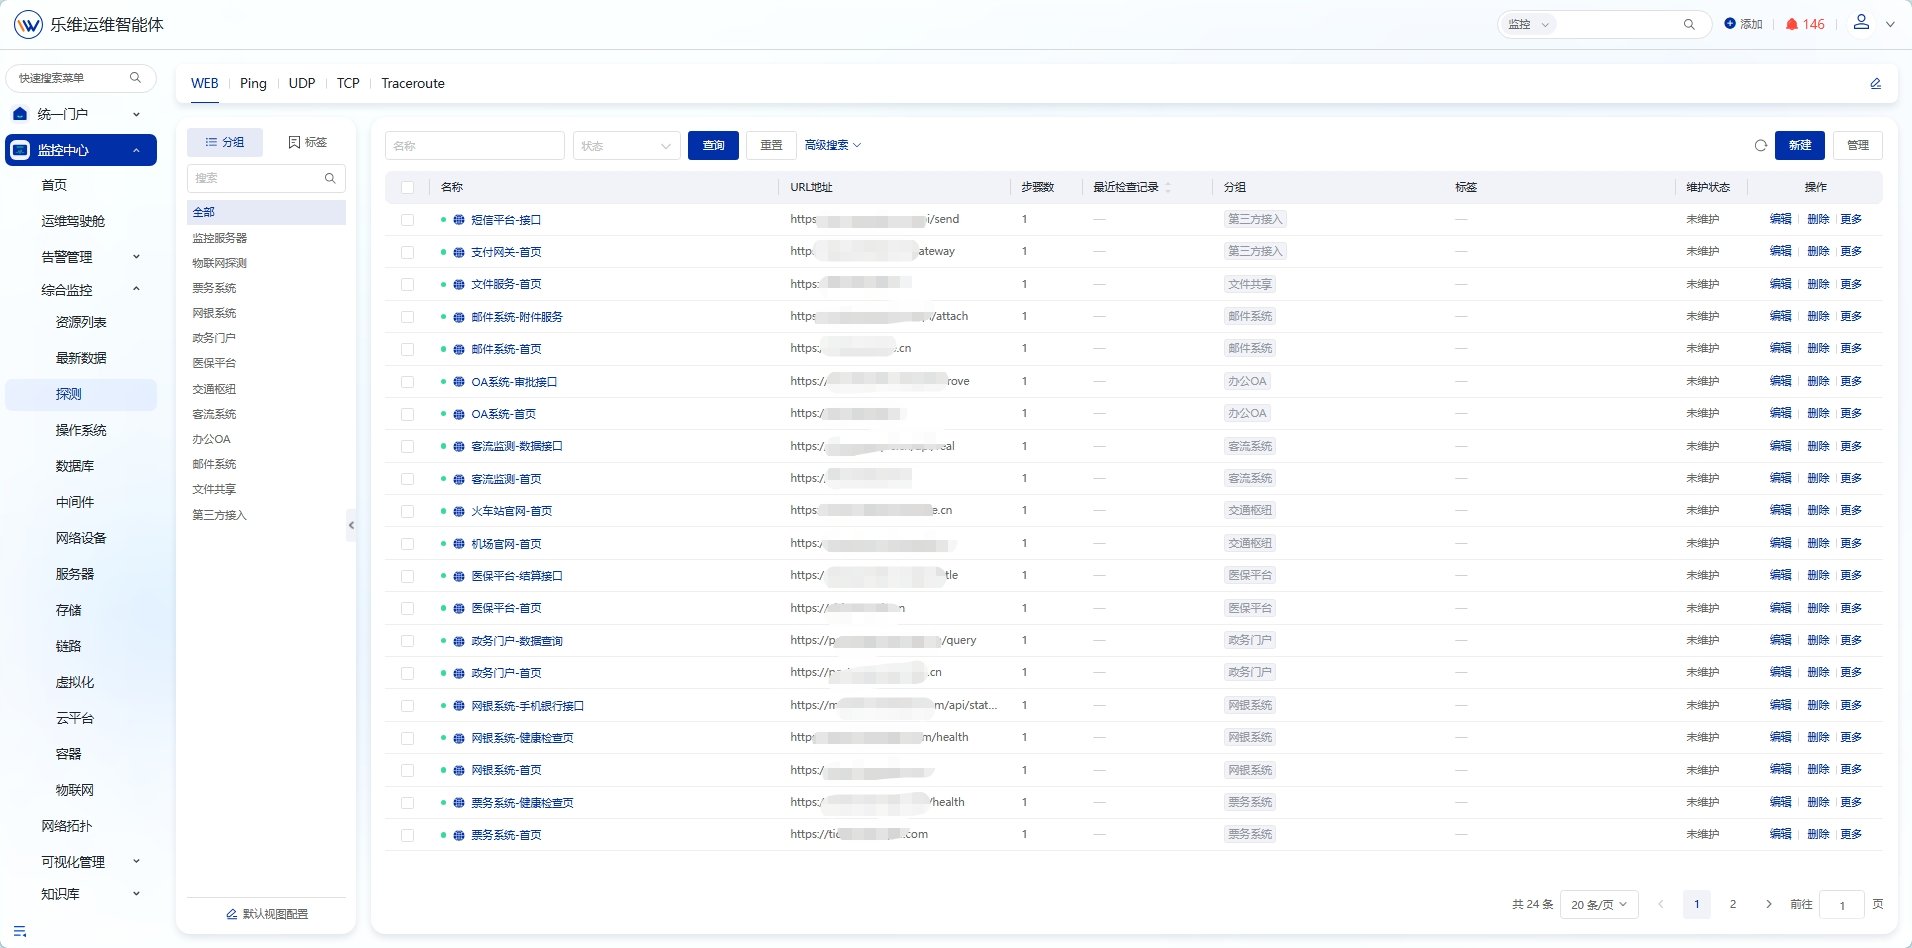
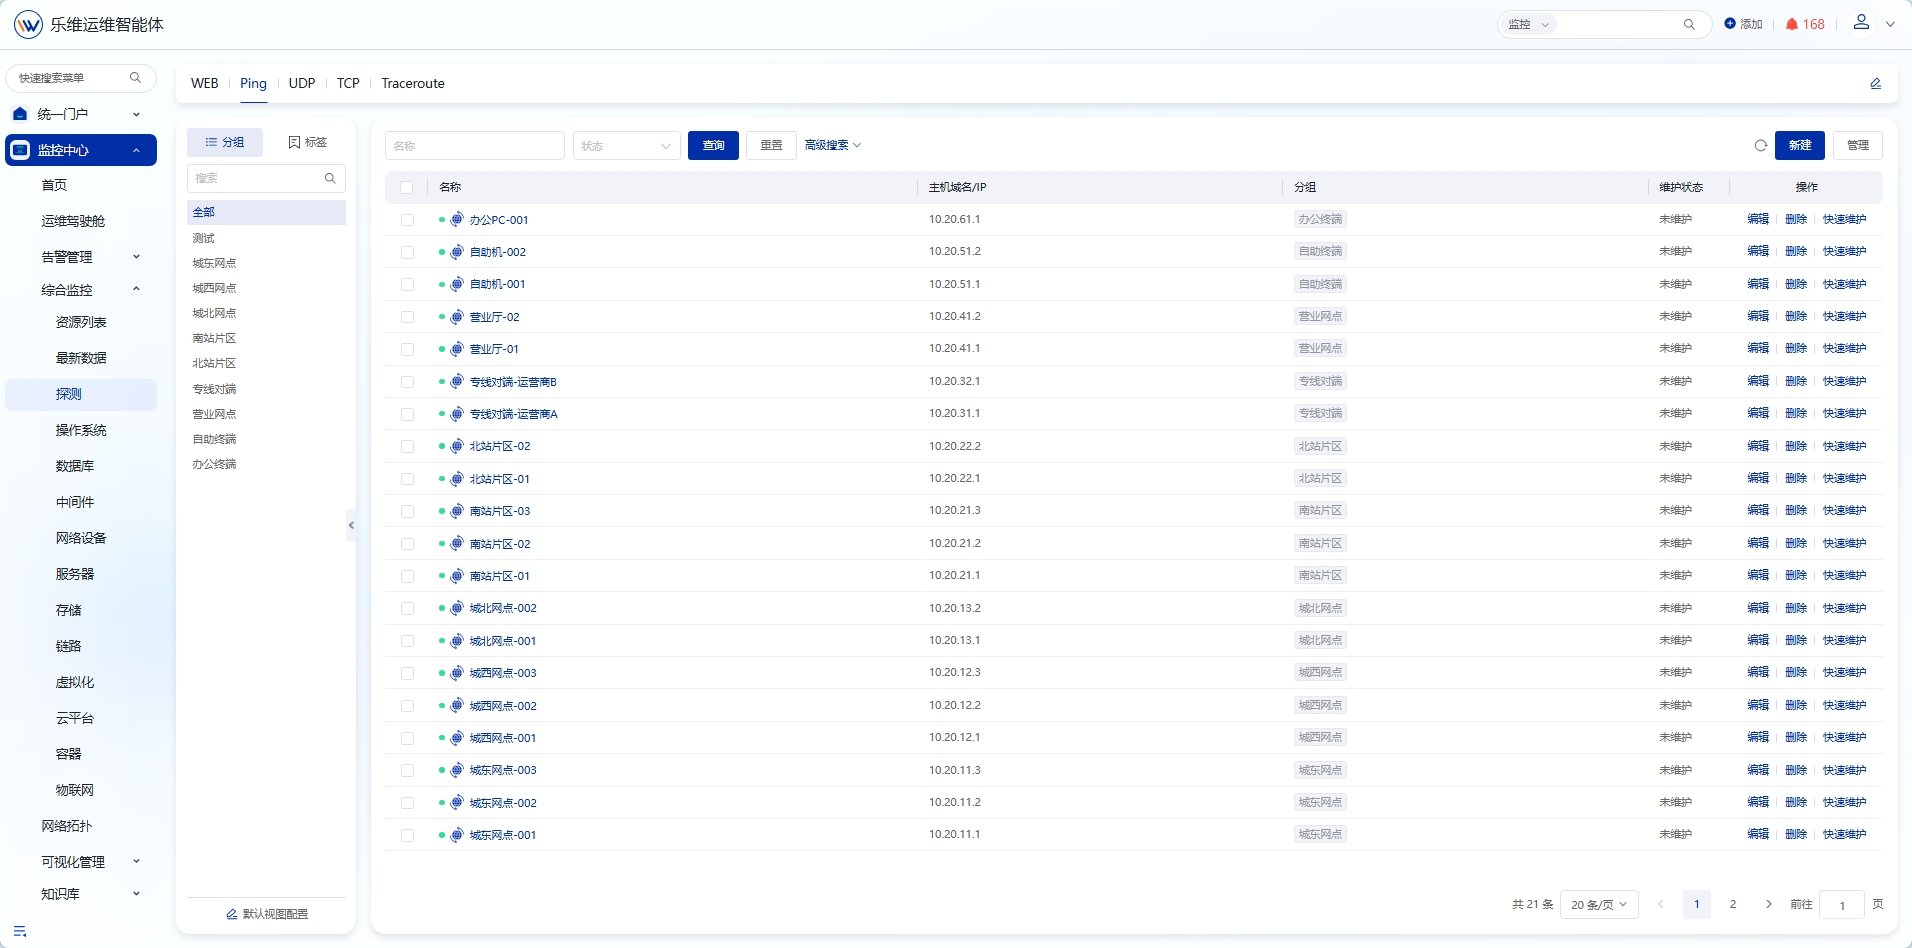
一批对象建完探测后会全部平铺在列表里,数量一多就没法查、没法管。名称和分组要在建探测时一起设计——名称解决「列表里哪一条是哪台」,分组解决「这批归谁」。分组按业务系统建。各类探测回答的问题不同:Ping 类回答「哪一片网络断了」,WEB / TCP 类回答「哪个业务出了问题」。
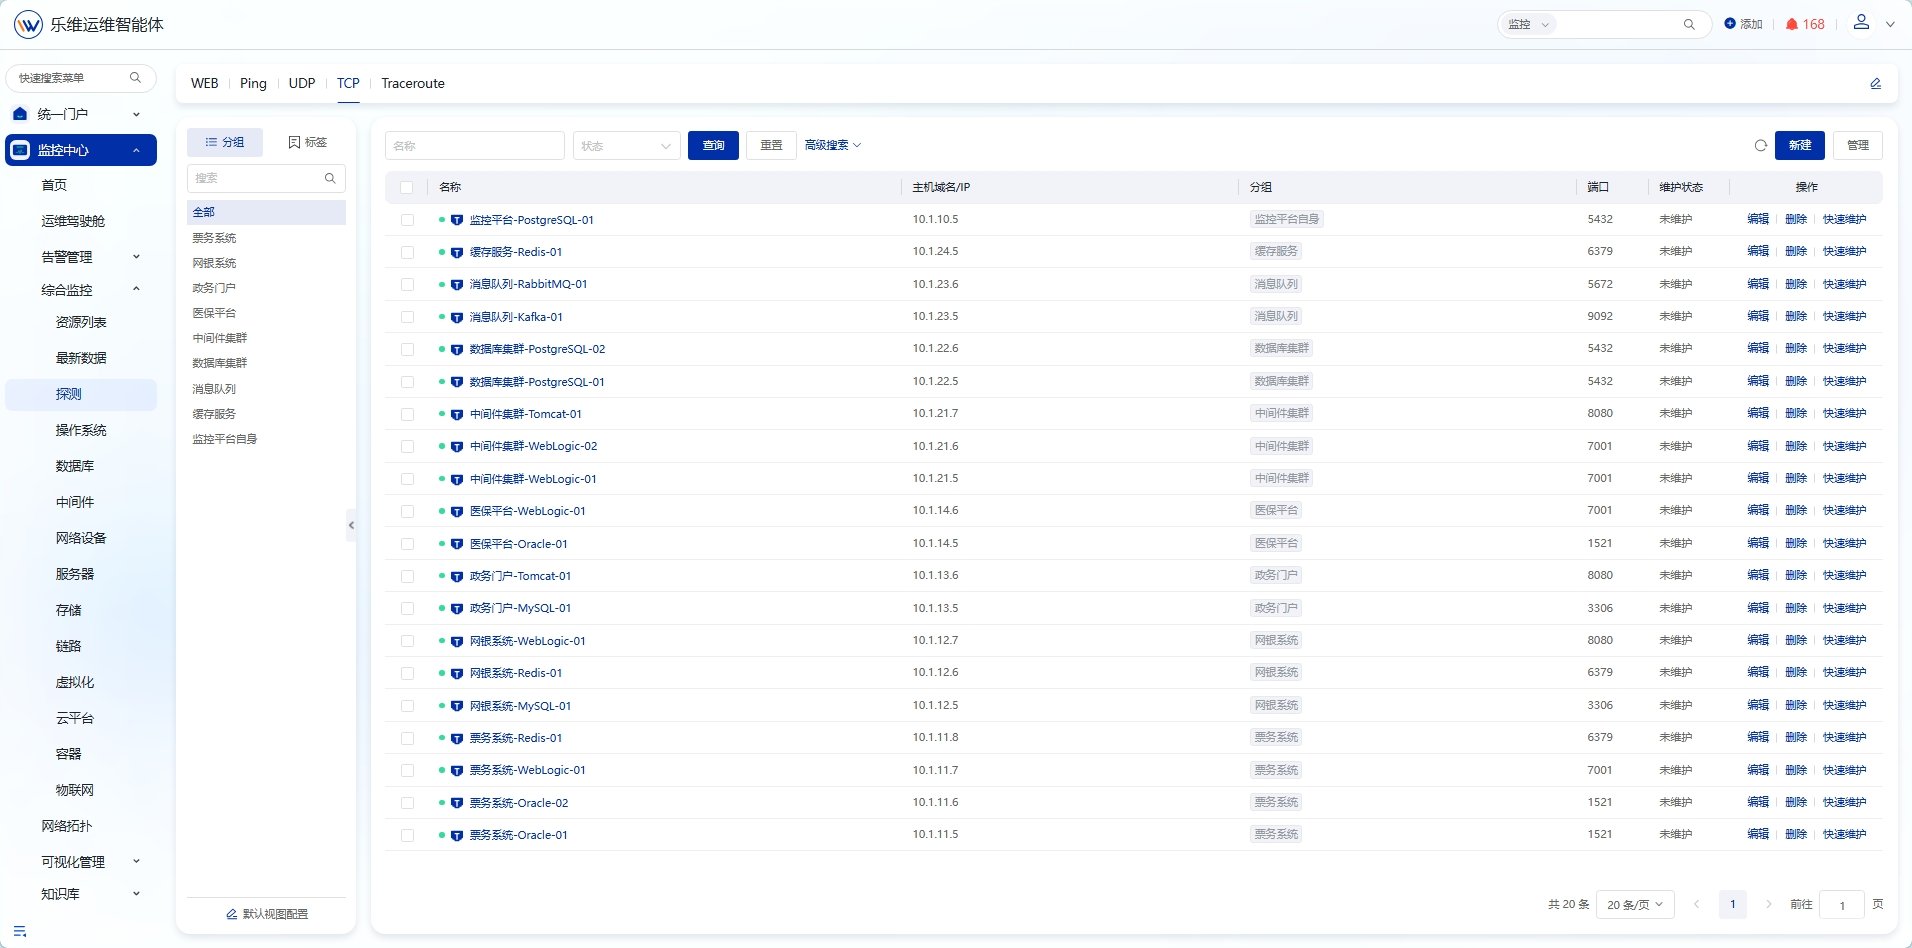
命名规划:以 TCP 探测为例
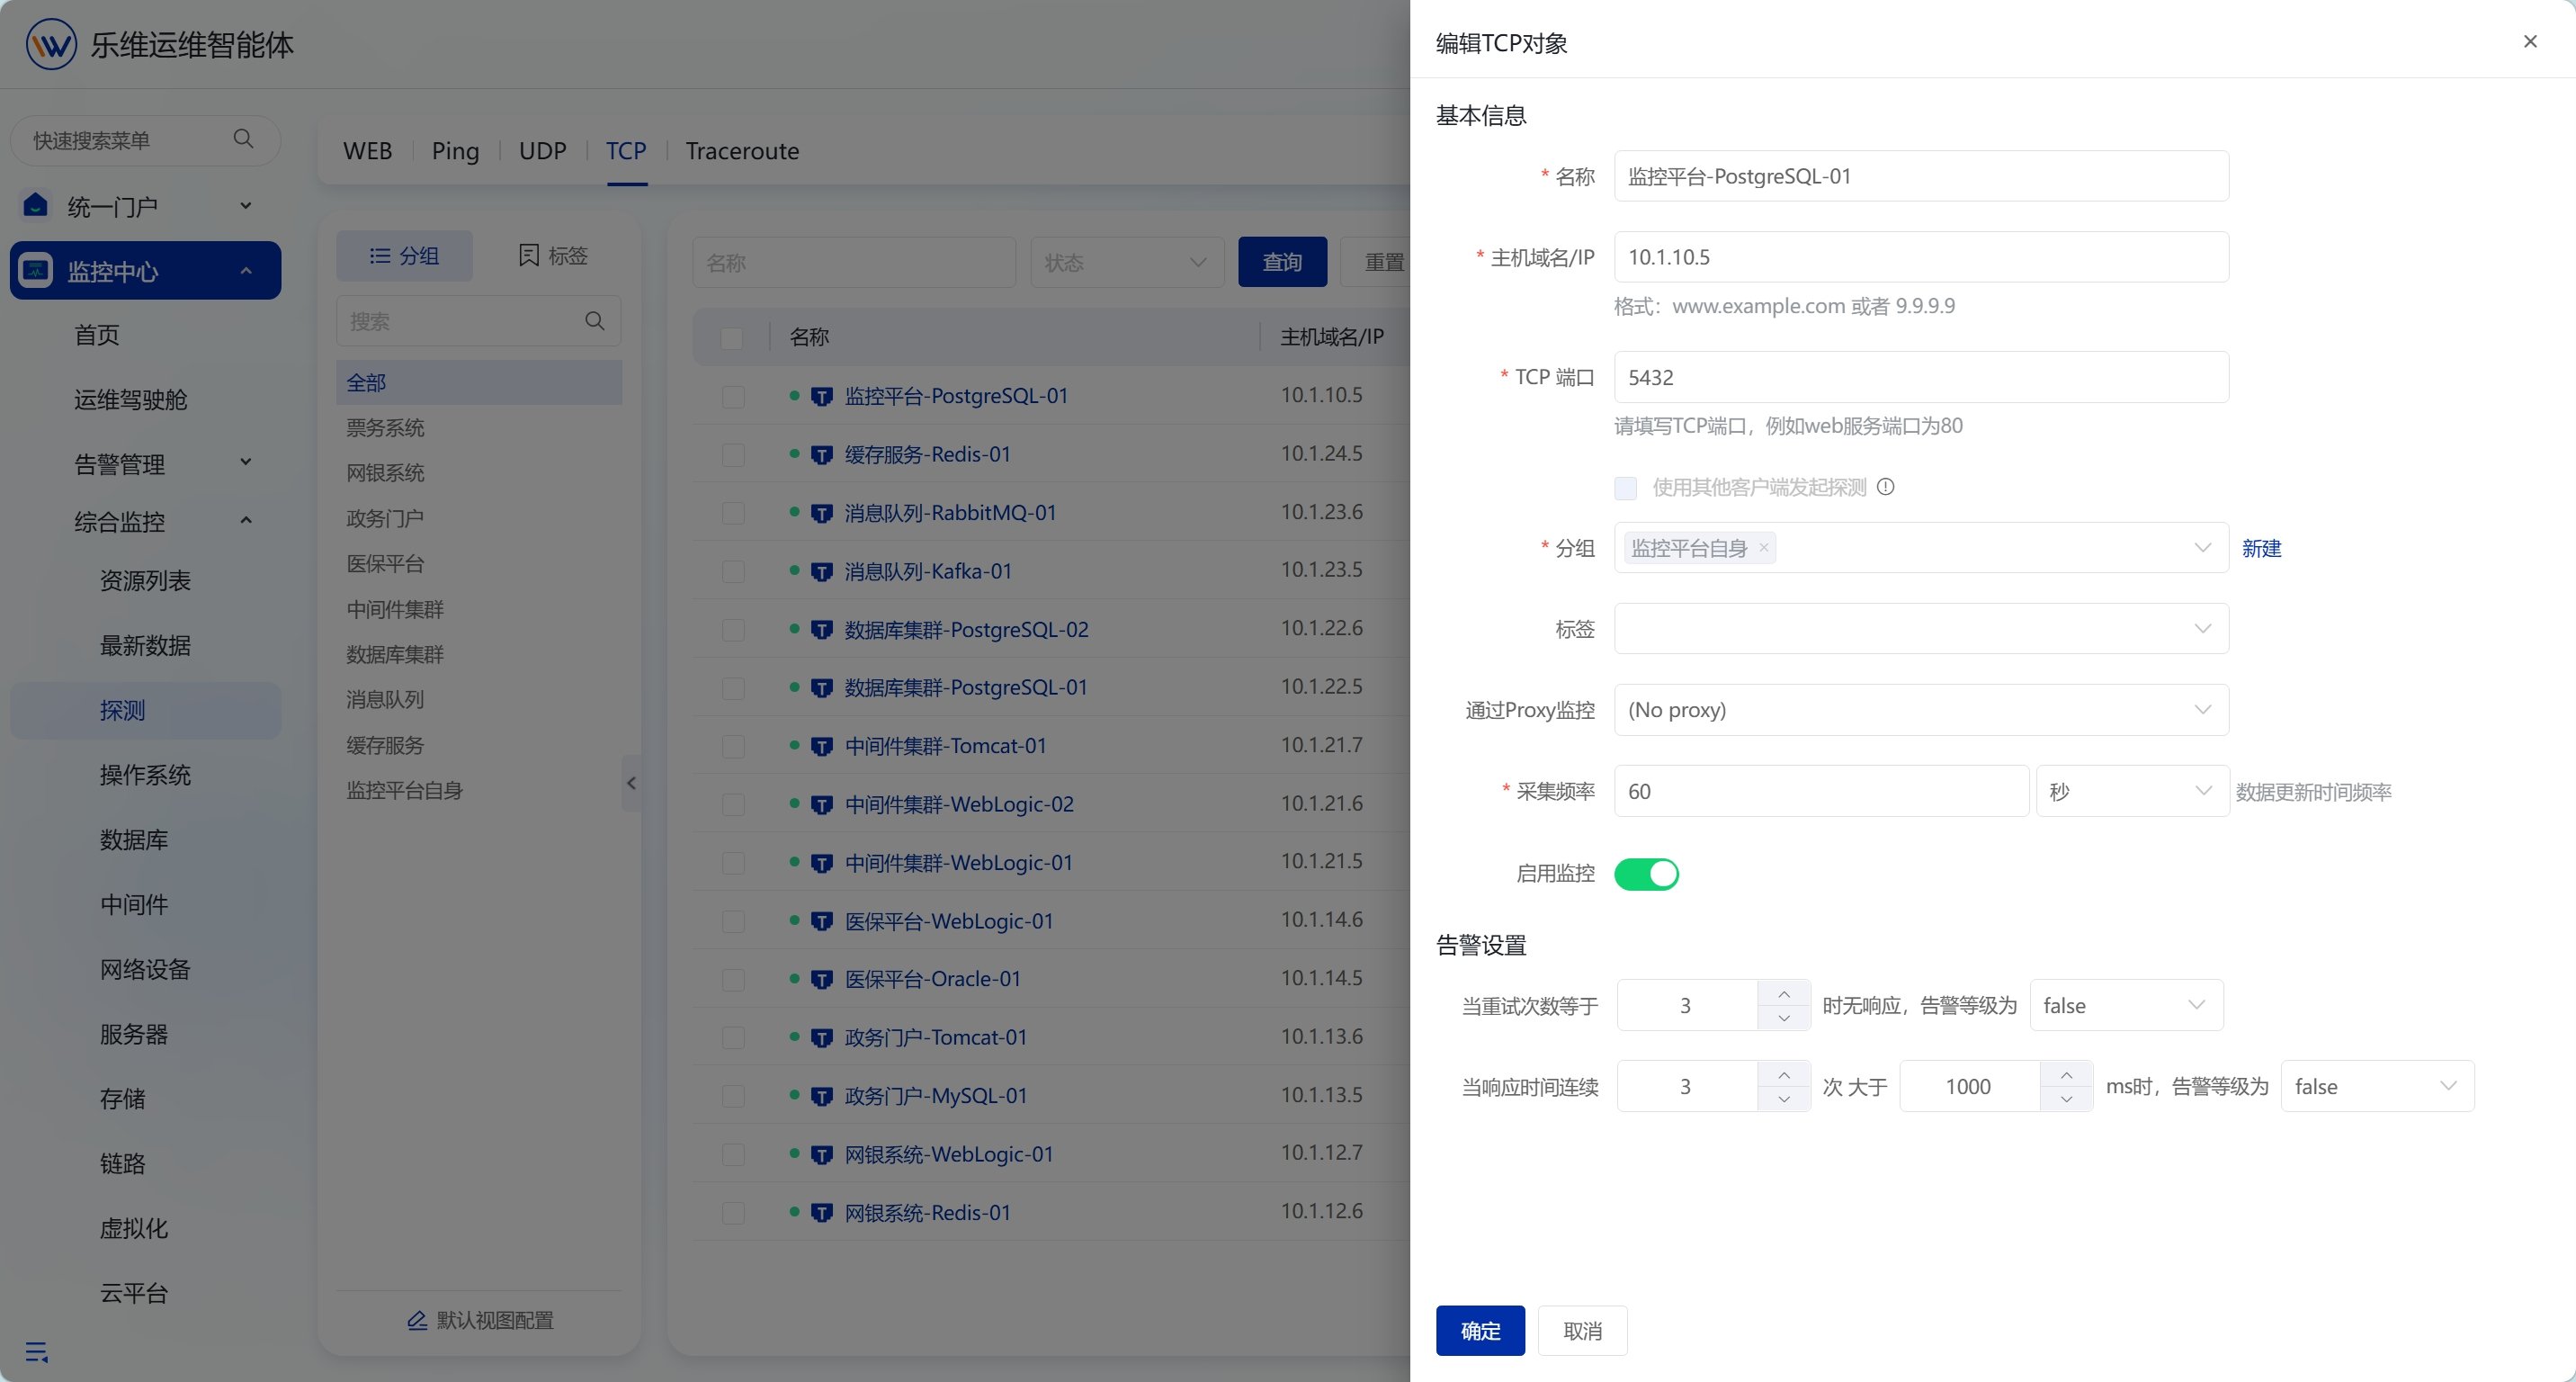
TCP 探测的对象是承载业务服务的端口,名称和分组要一起设计——名称解决「列表里哪一条是哪台」,分组解决「这批归谁」。
名称按「业务 + 角色 + 实例」定义,三段式:
3.3 问题与处理方式
4.典型应用场景
场景一:批量 IP 存活监测与离线告警
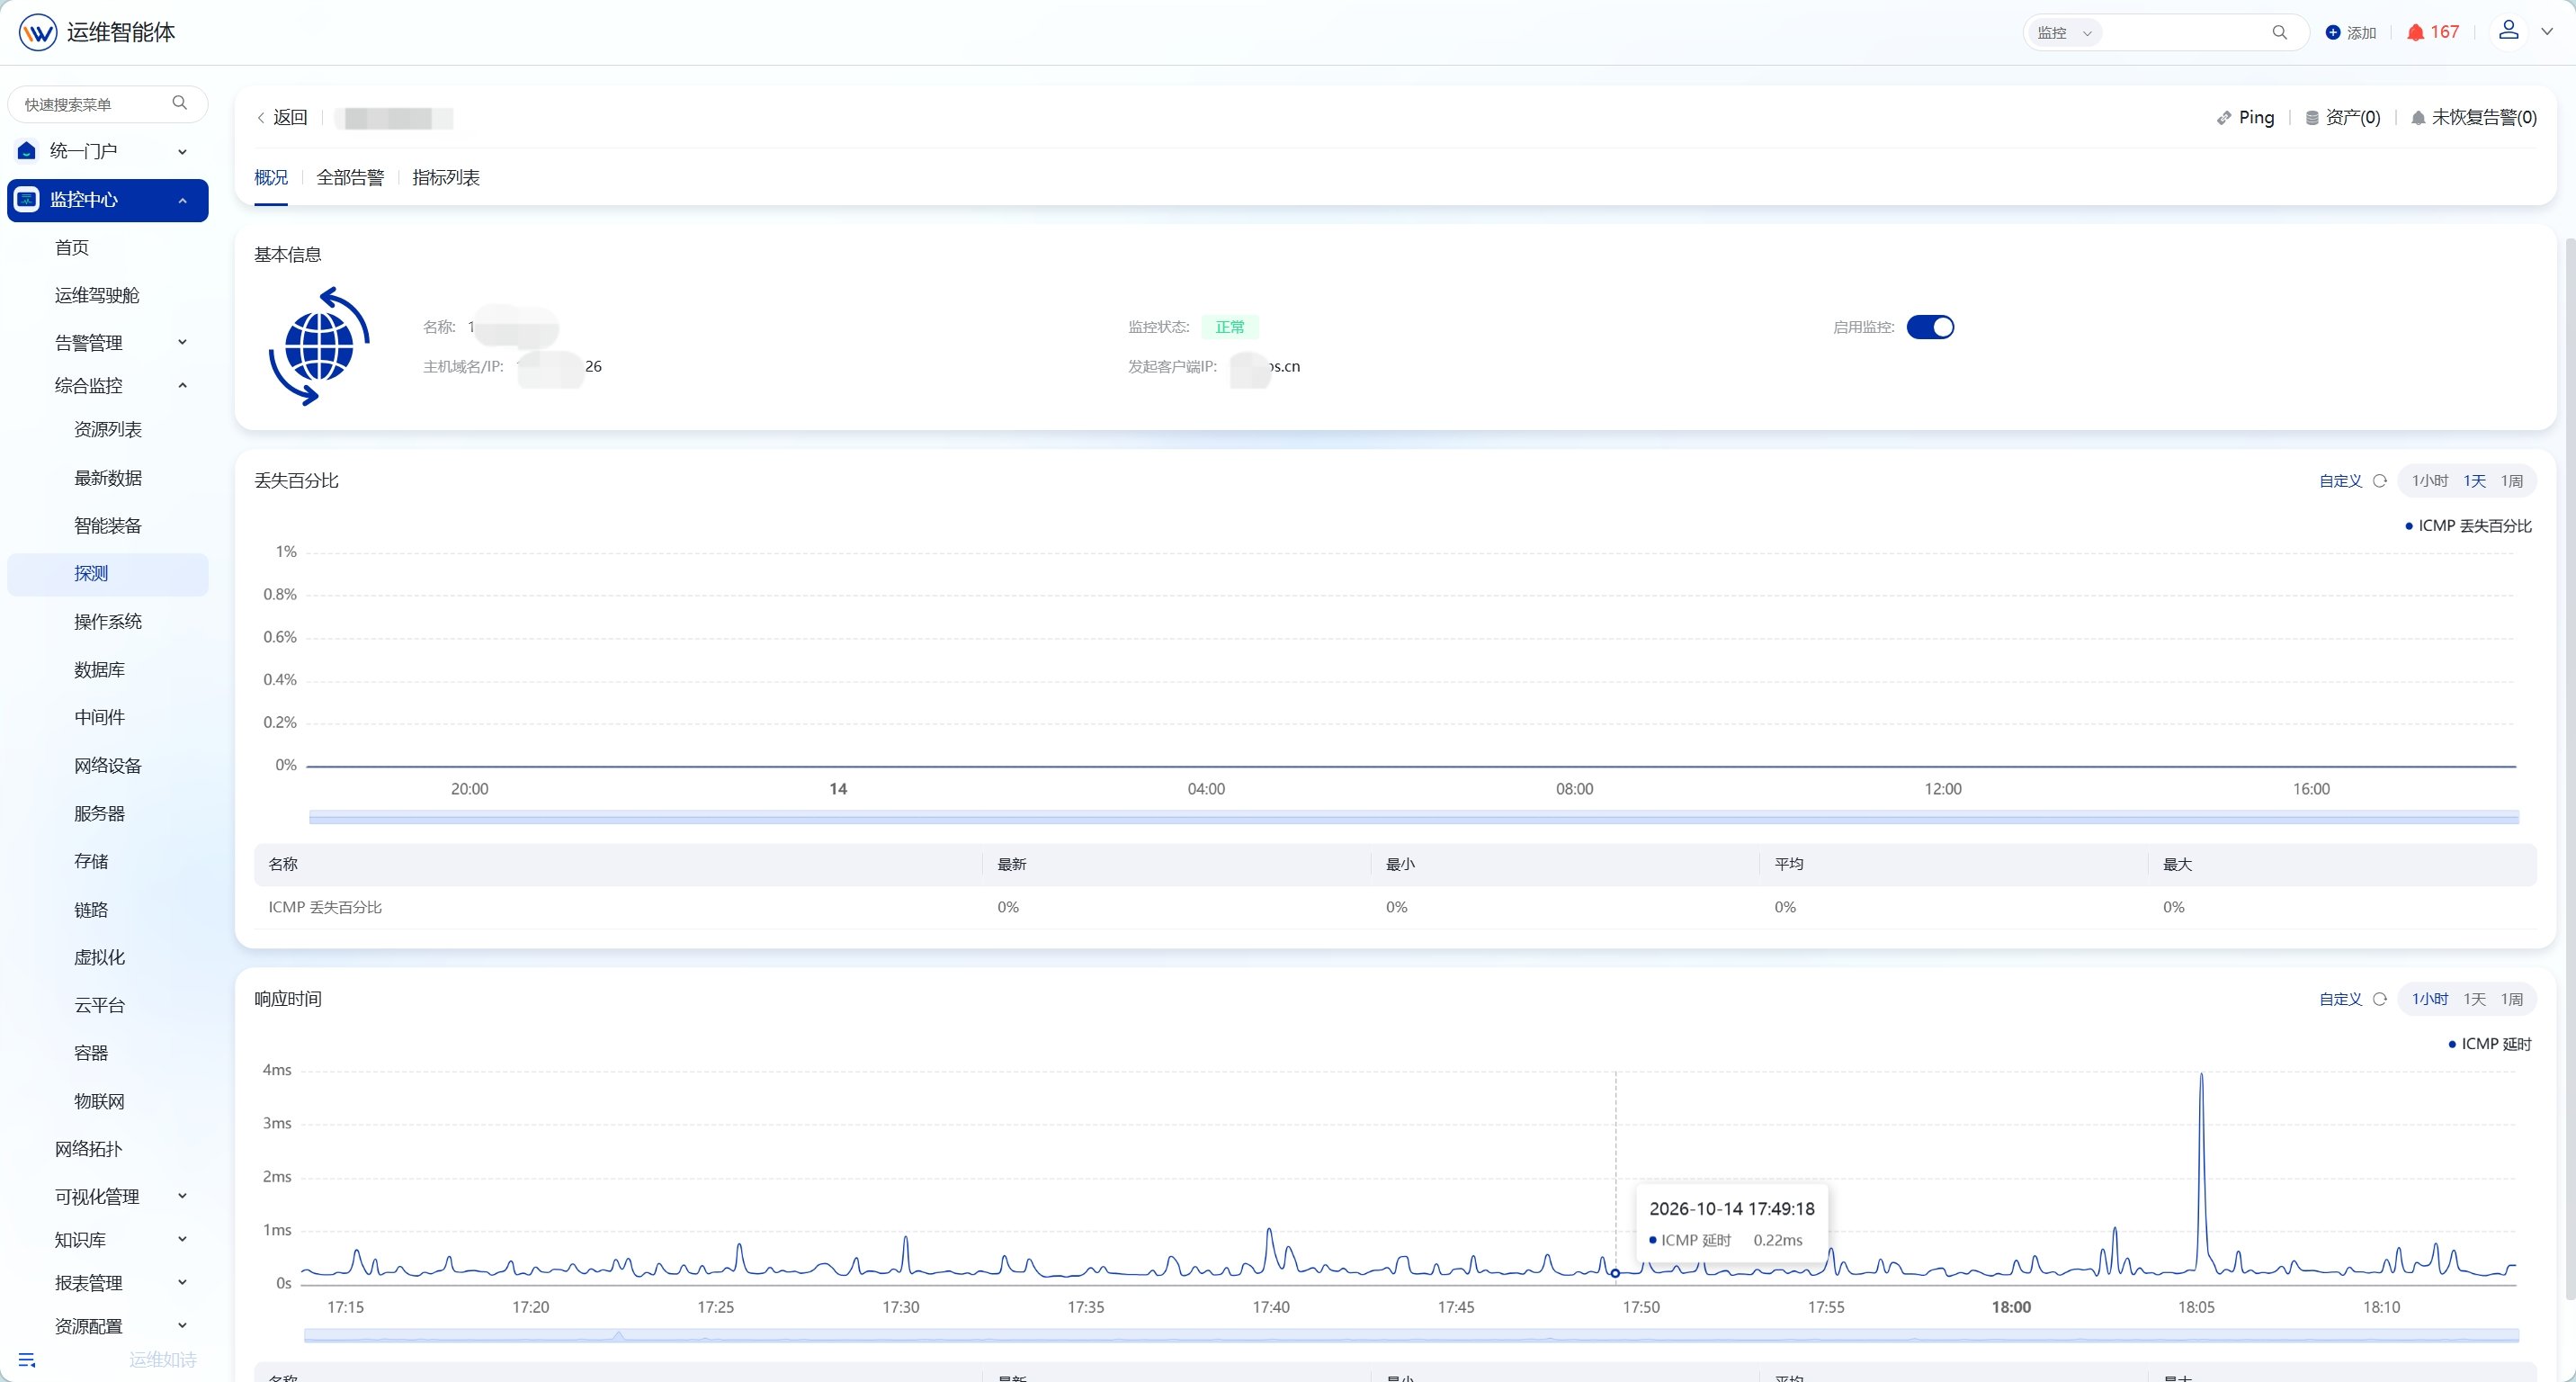
问题: 客户约 150 个网点 IP 需监测,网点无人值守,断网只能靠用户报障,发现严重滞后;人工 ping 无法持续,也无法区分单点故障还是线路批量故障。 解决: 在【探测】模块中选择 Ping 探测,按网段分组后用 Excel 模板批量导入,探测周期 1 分钟;离线、丢包、时延异常自动告警并推送值班群。 效果: 150 个 IP 一屏总览,离线分钟级发现,无需用户报障;月均主动发现网点离线 20 余次,且能快速区分单点故障与线路批量故障。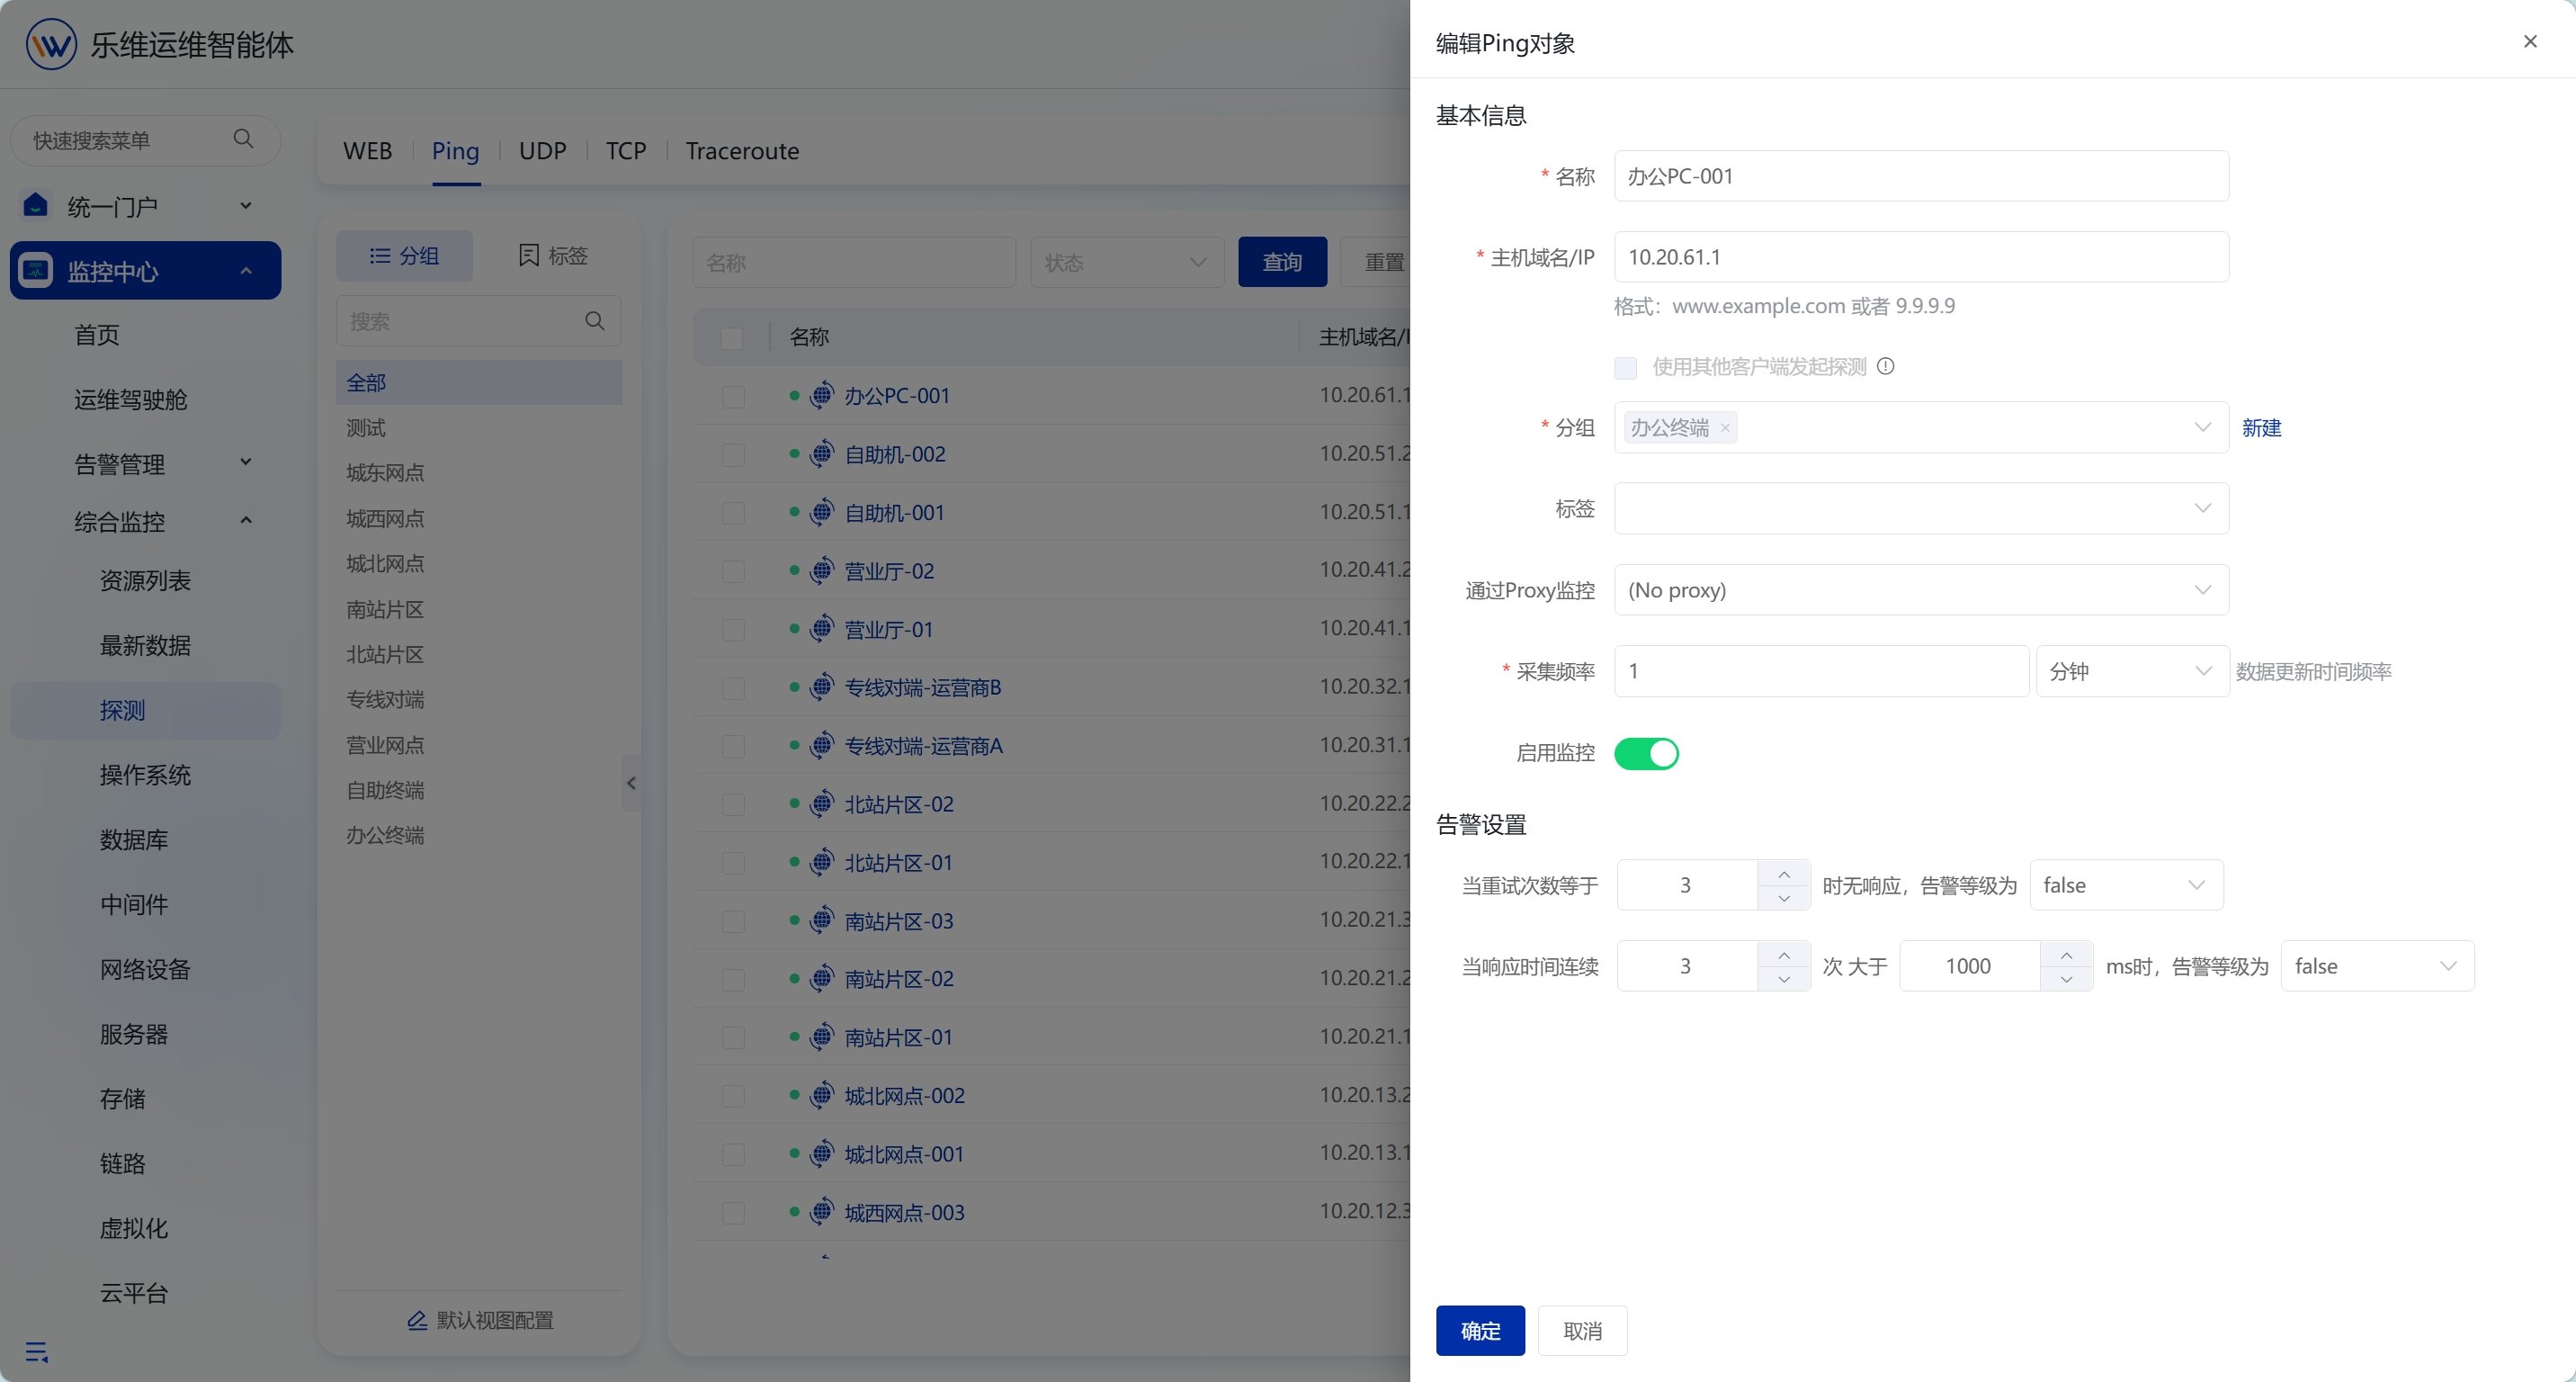
场景二:业务系统 WEB 可用性监测
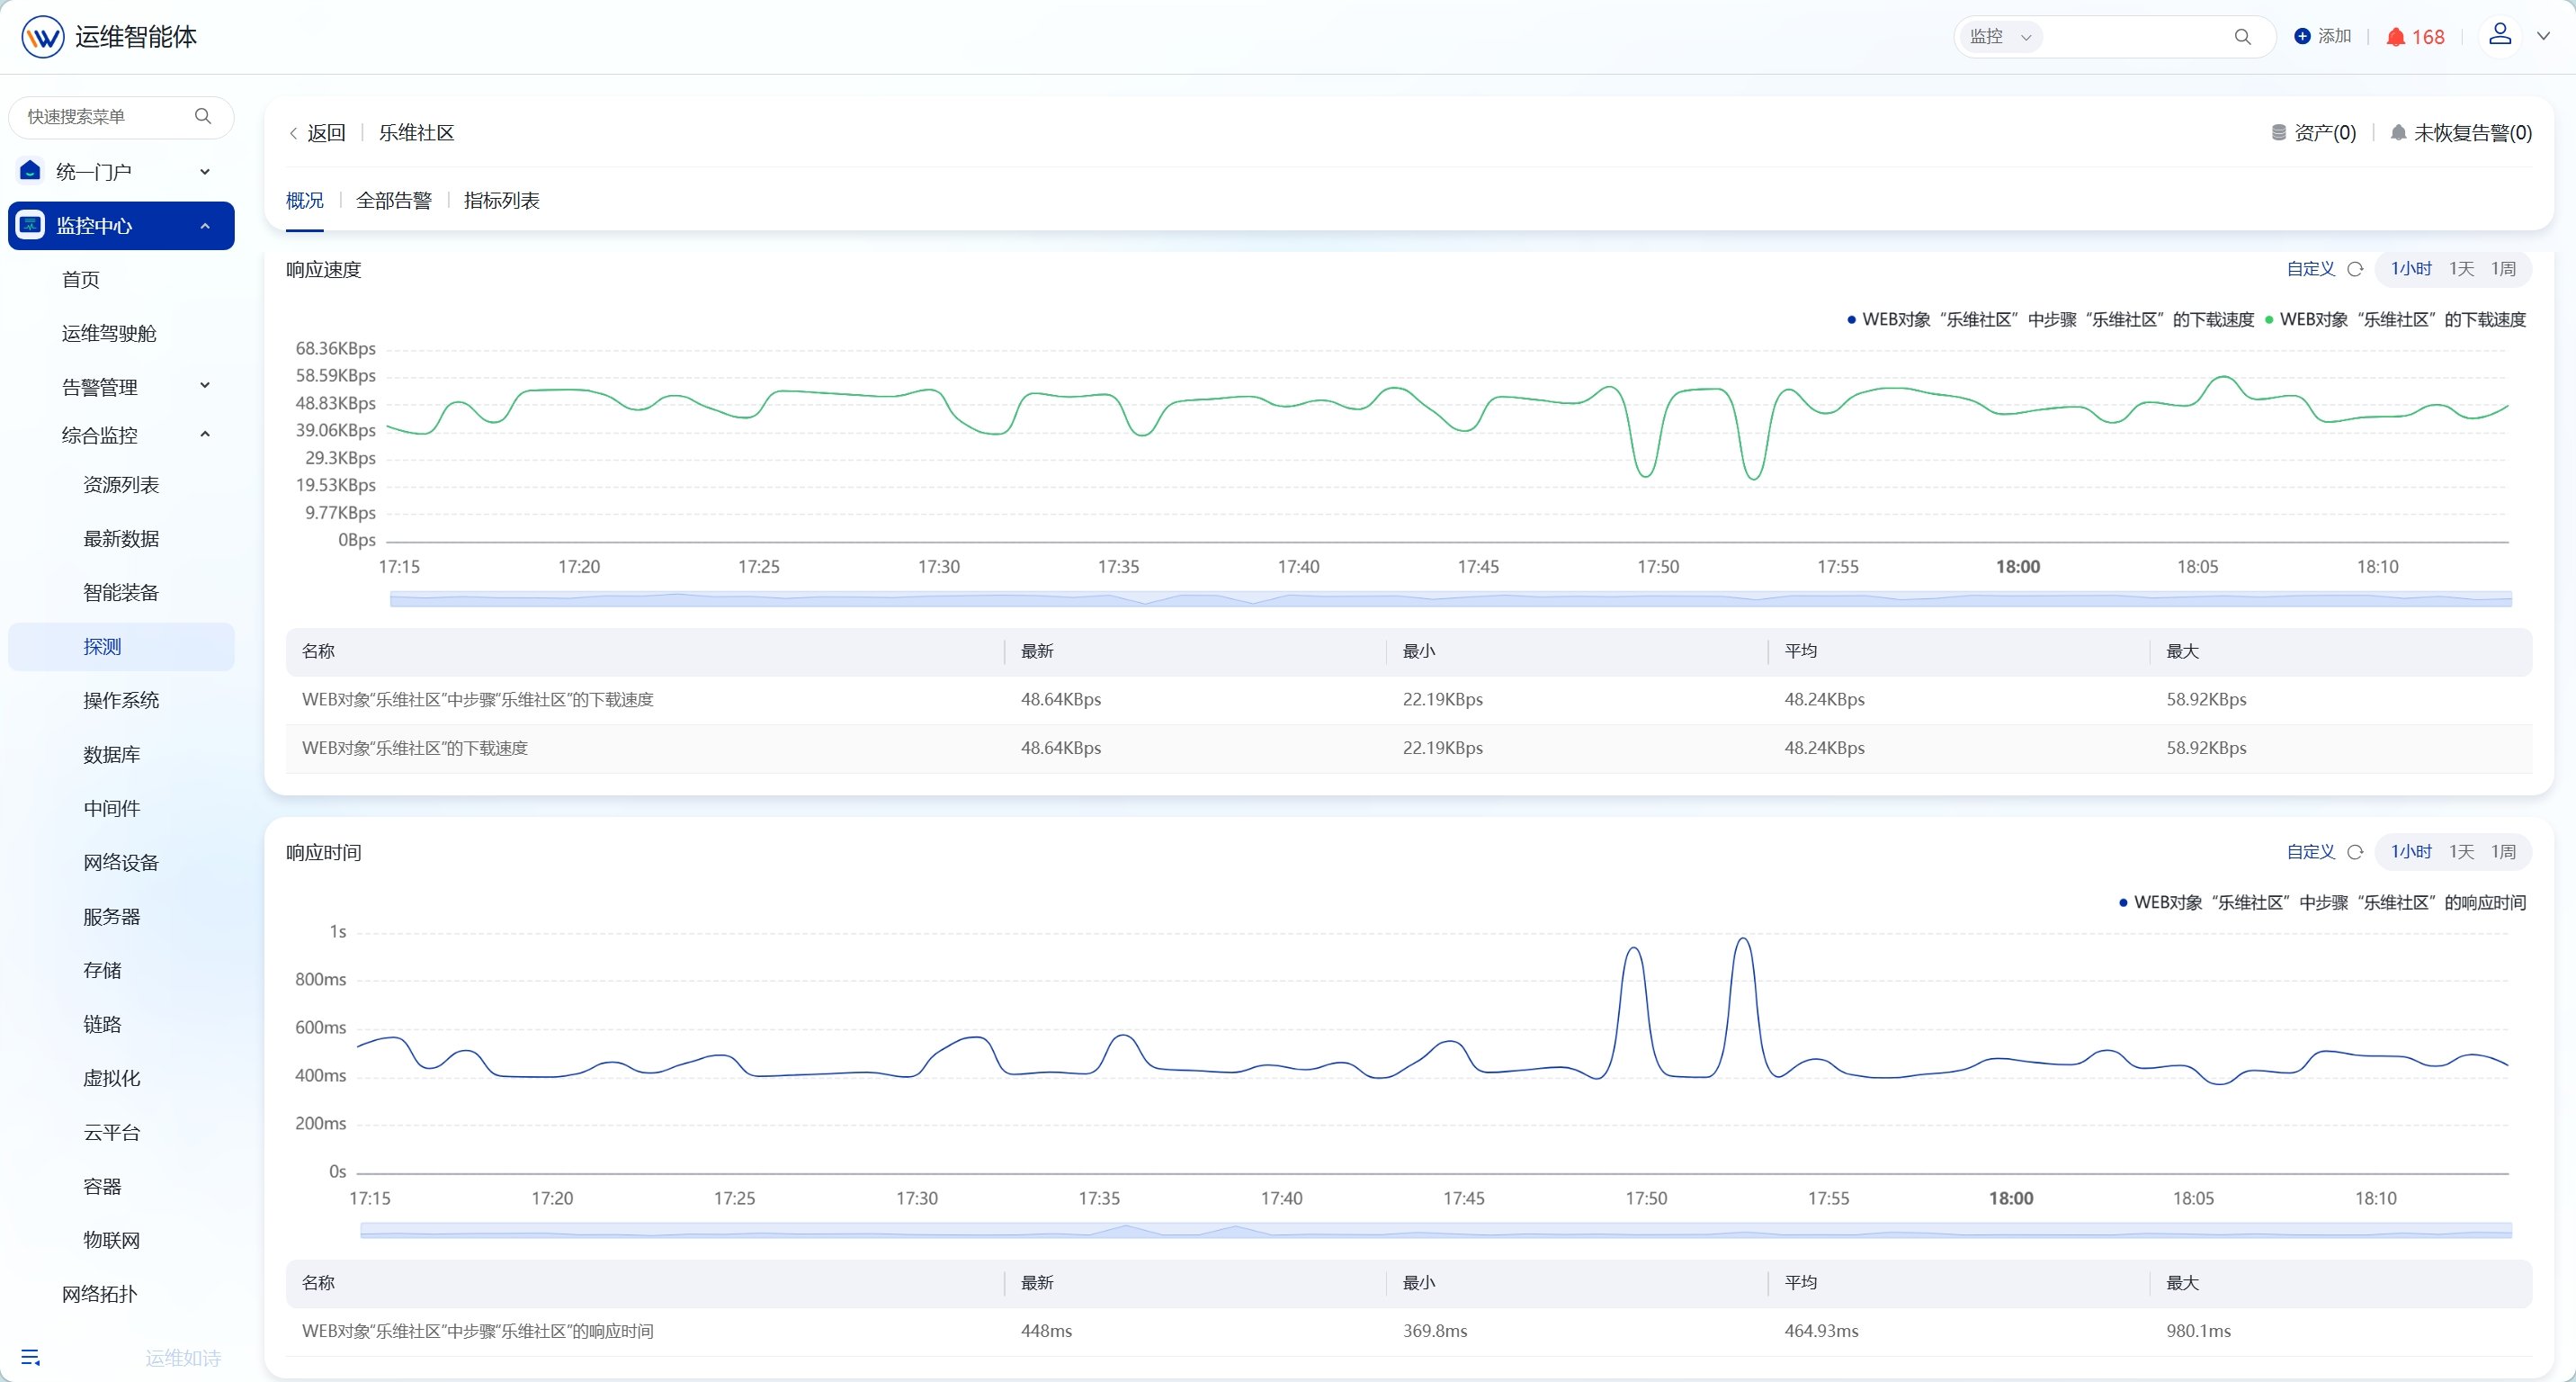
问题: 客户 20 个业务系统,「能 ping 通但页面打不开、返回错误页」的故障监控感知不到,全靠用户反馈才知道。 解决: 在【探测】模块中选择 WEB 探测,对每个系统的首页或健康检查页配置探测:状态码校验 200、字符串做页面关键字校验,周期 1 分钟。 效果: 页面级故障分钟级发现,无需用户反馈;响应时间趋势可提前发现系统变慢,在业务高峰前完成处置;业务系统的月度可用率统计可稳定在 99.9% 以上。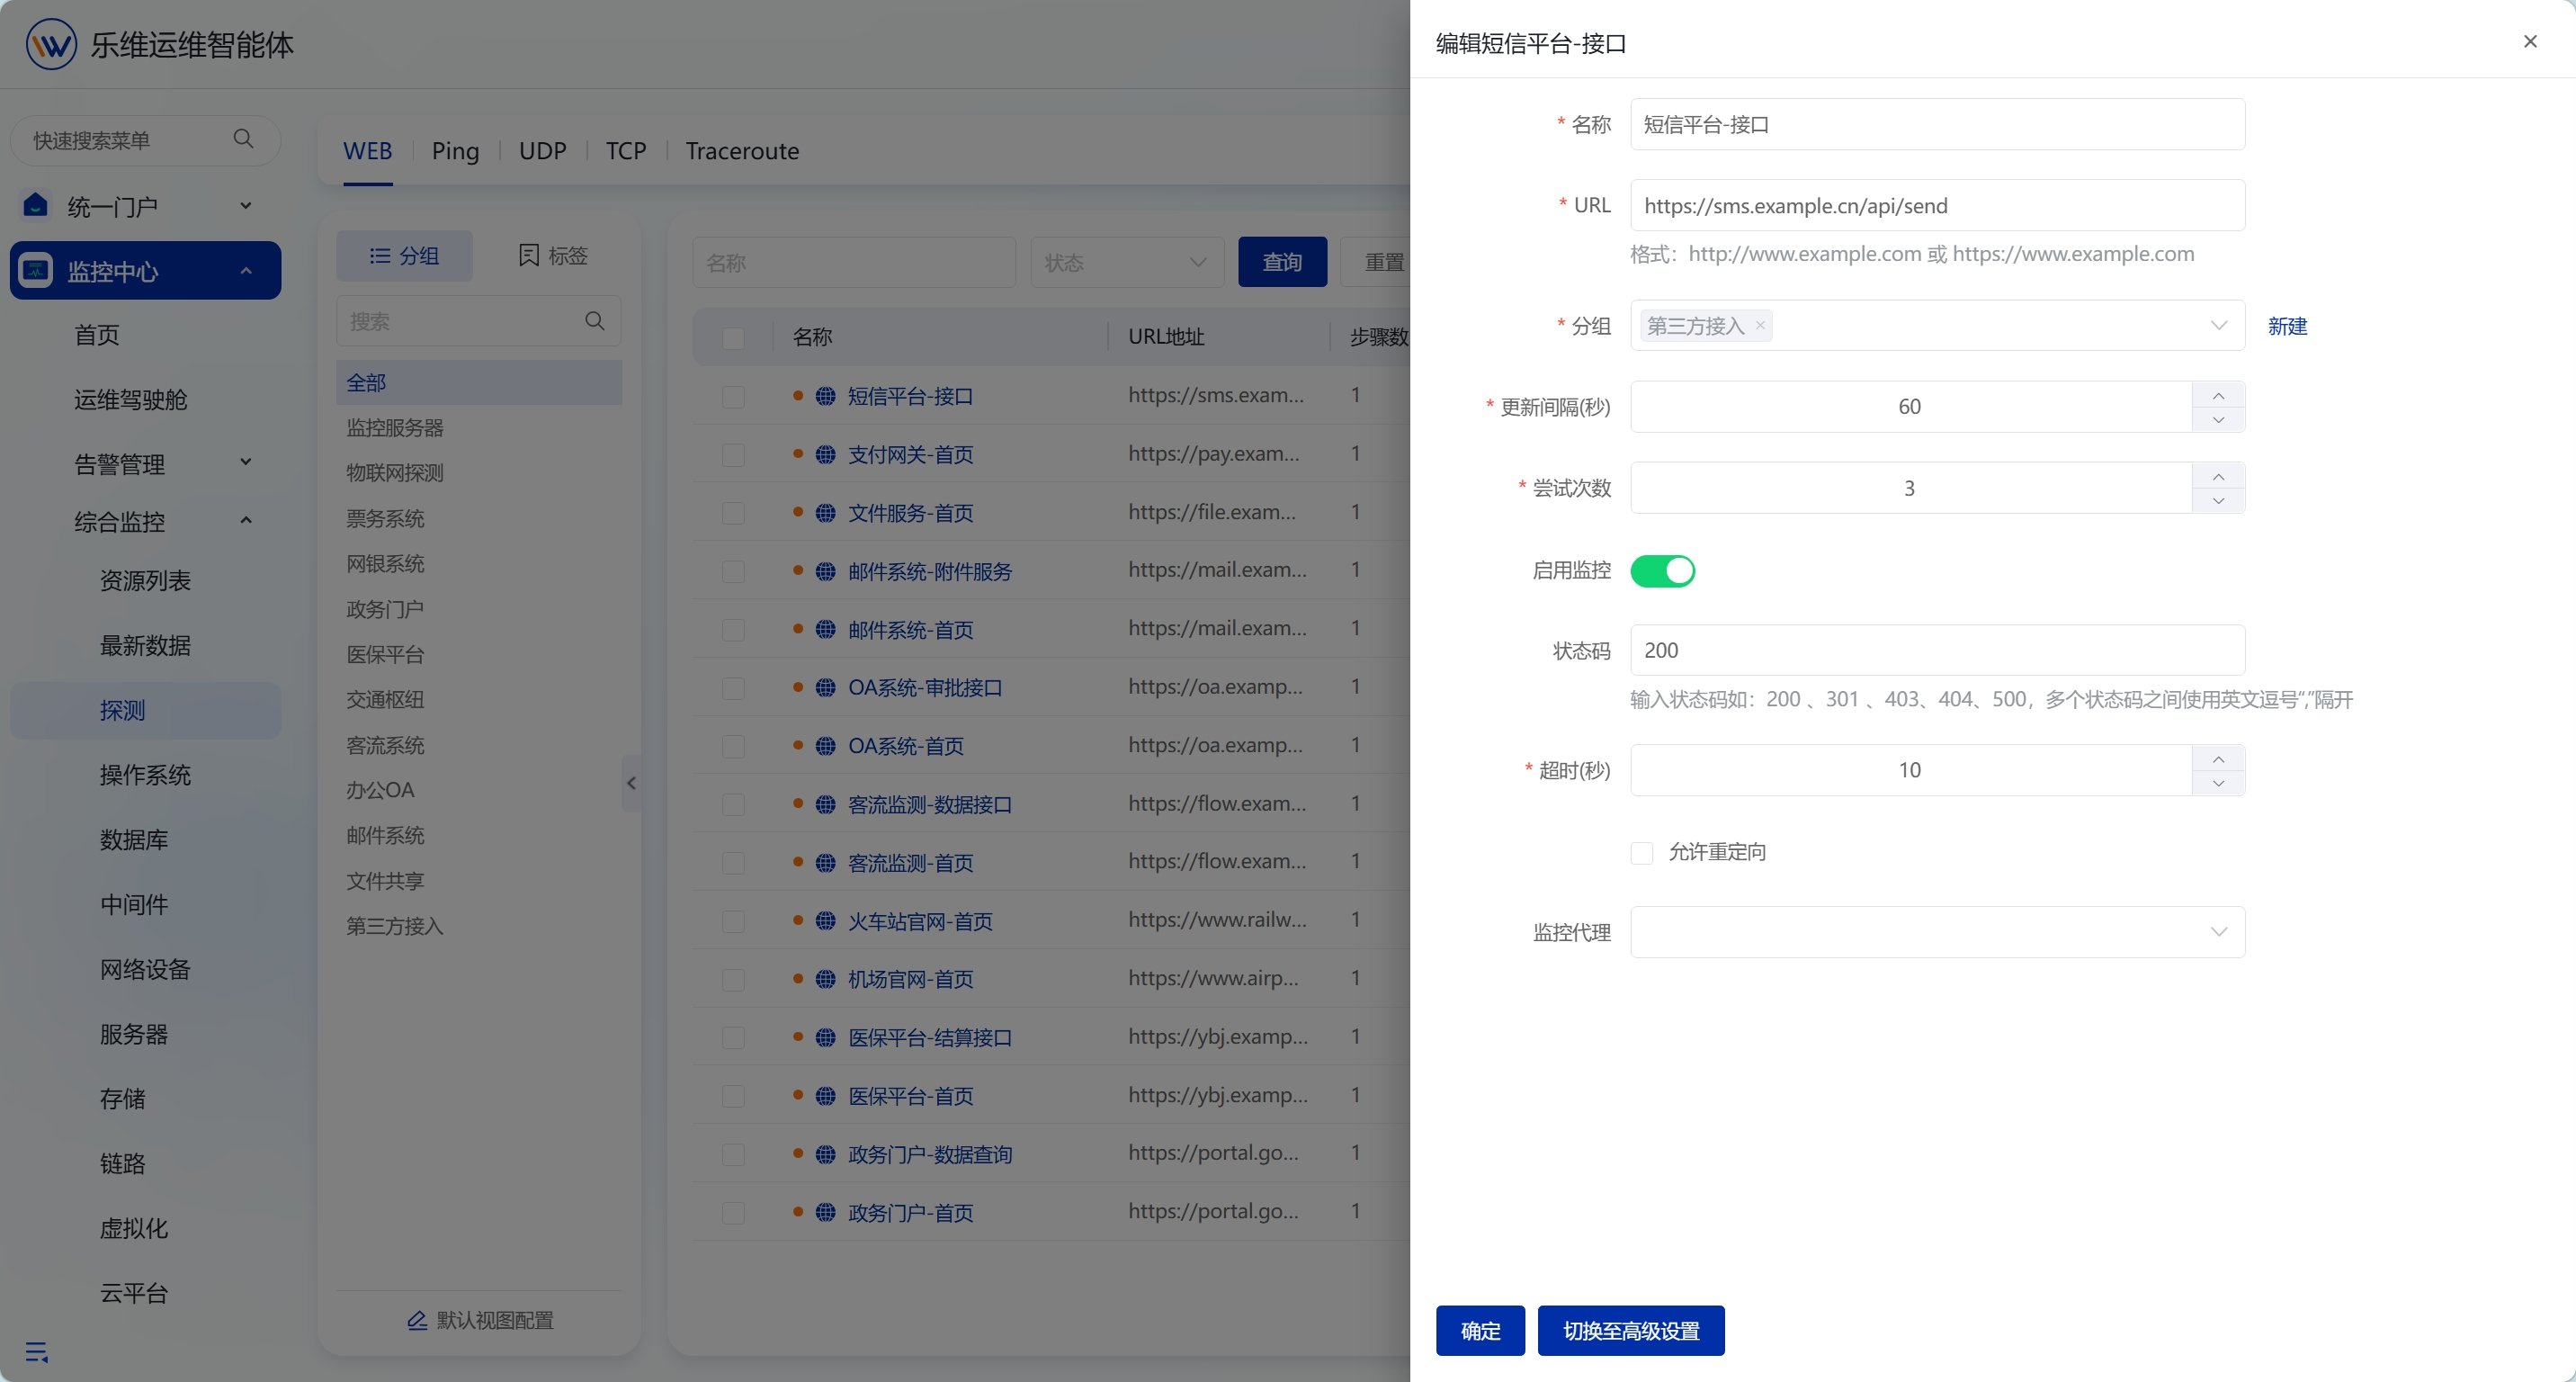
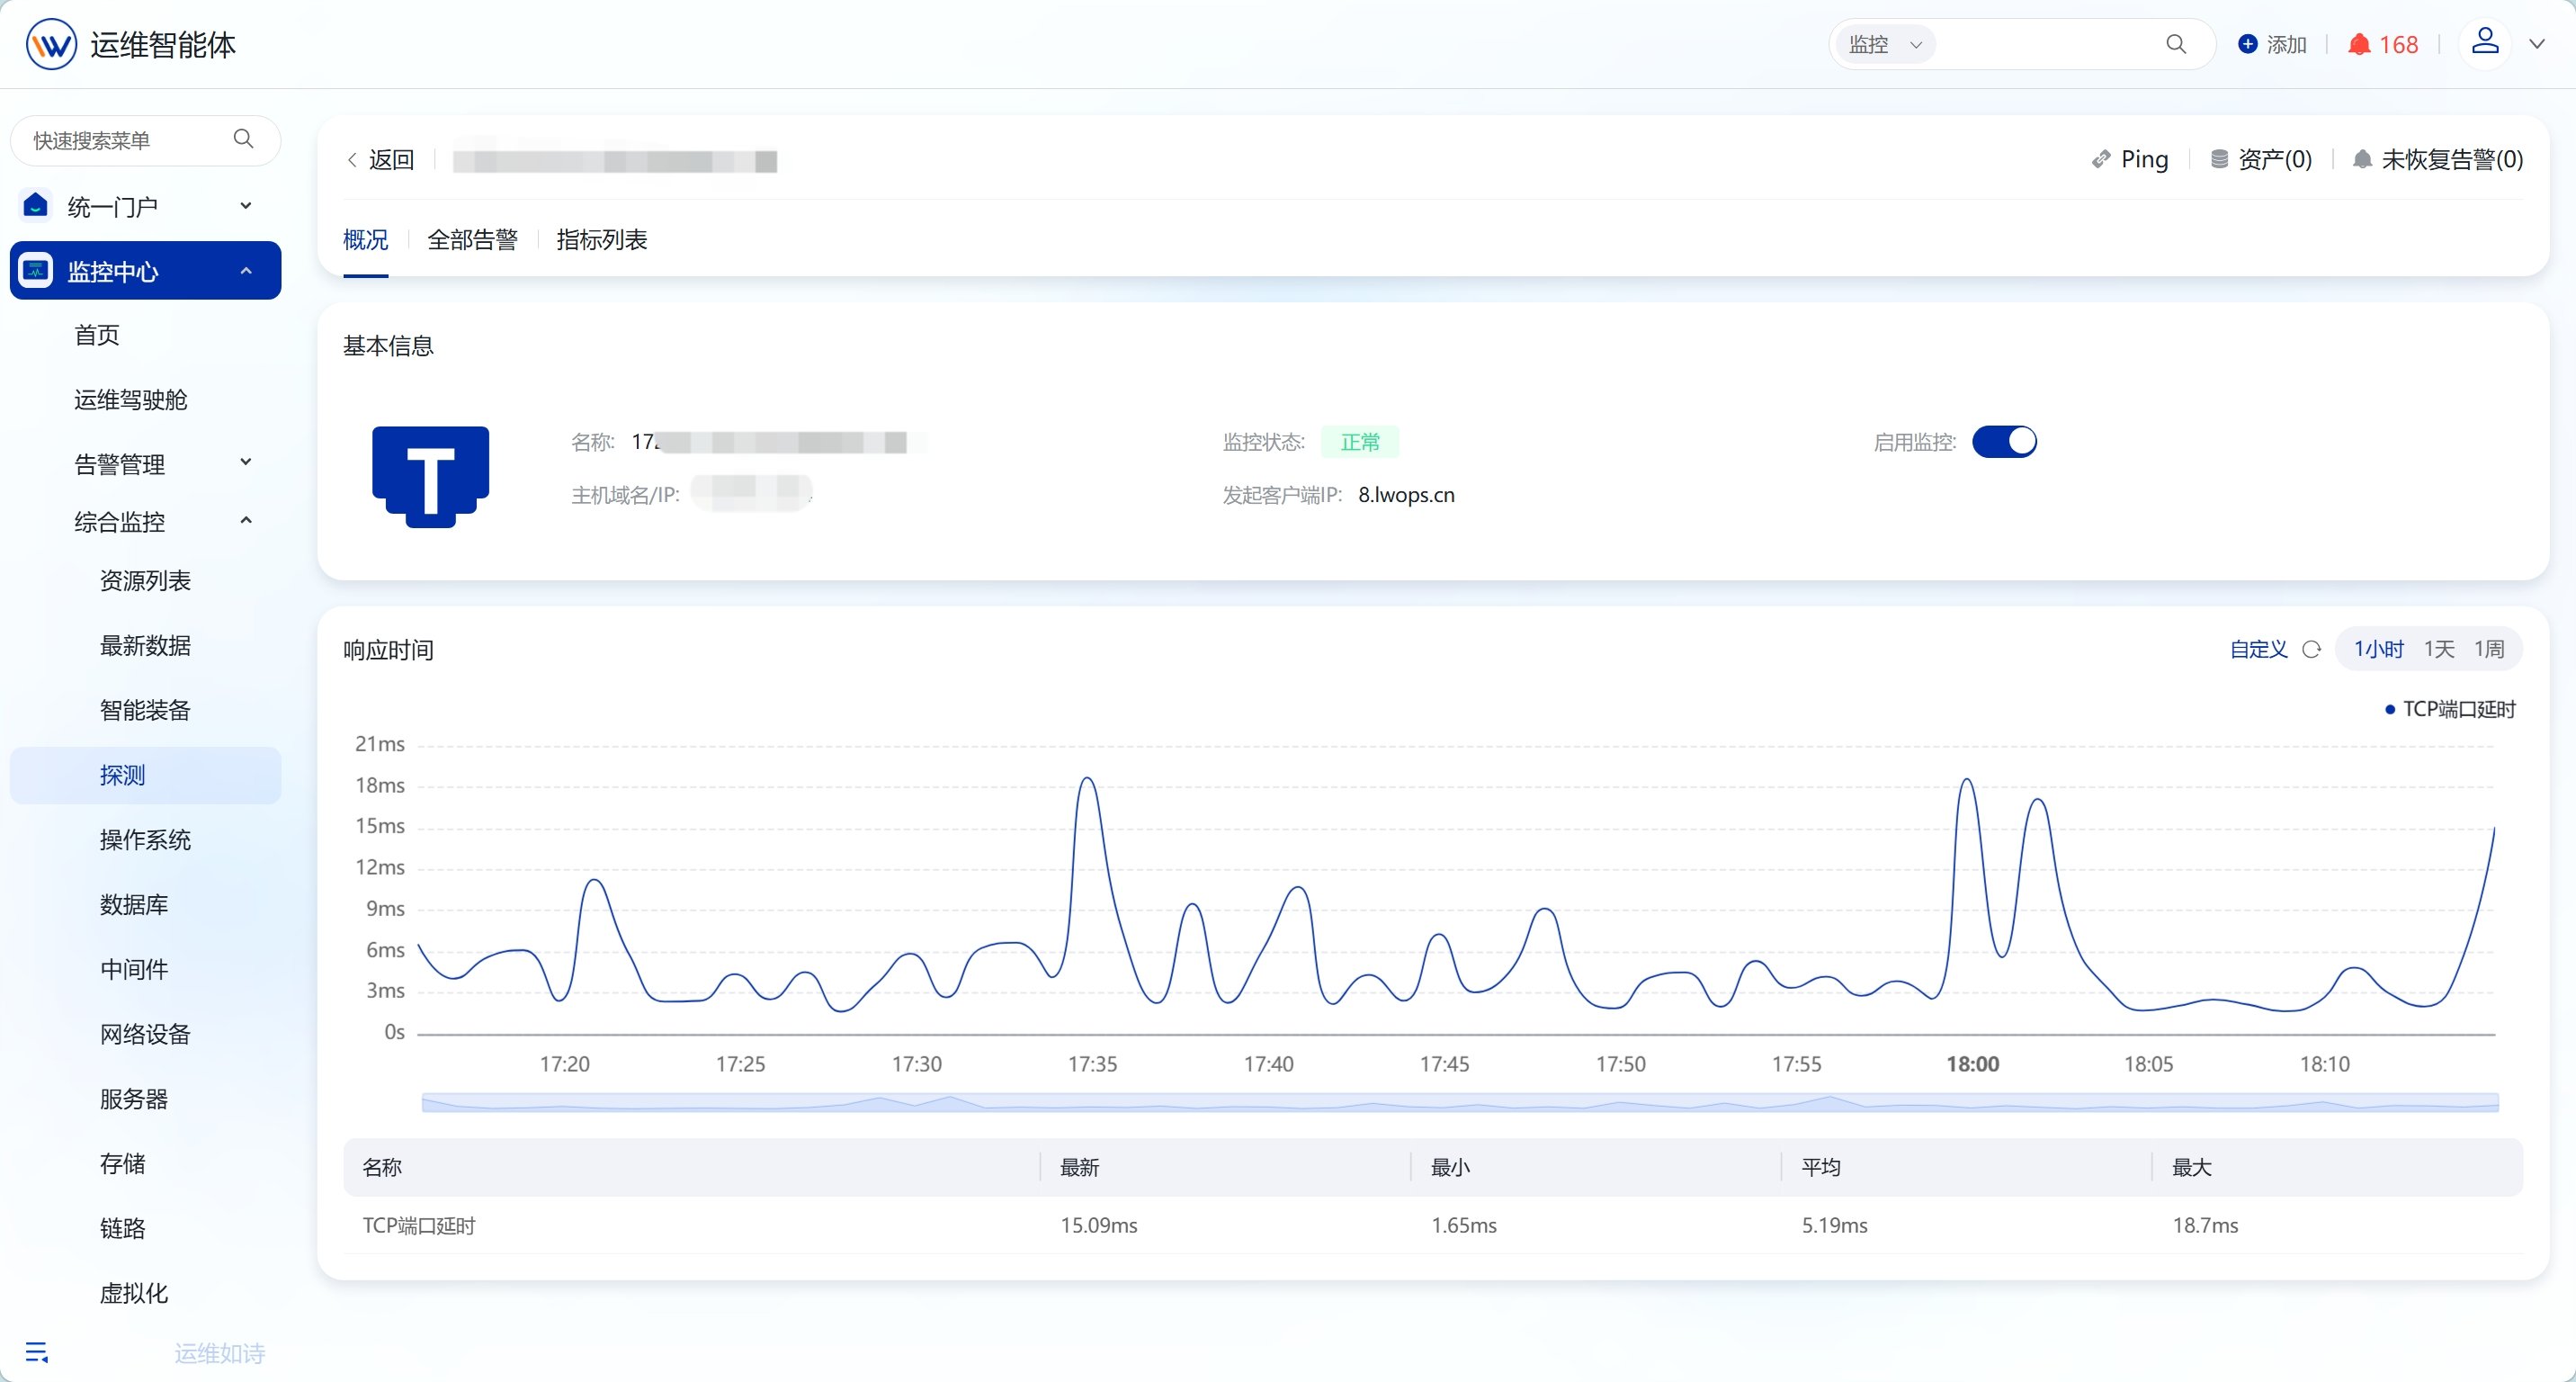
场景三:关键服务端口(TCP)探测
问题: 数据库、中间件等核心服务进程僵死时,操作系统指标都正常,但端口已不可连,要等应用报错才发现,故障影响面已经扩大。 解决: 在【探测】模块中选择 TCP 端口探测,对 30 个关键服务端口(Oracle 1521、WebLogic 7001、Redis 6379、MySQL 3306 等)配置探测,端口不通即告警。 效果: 端口不通分钟级告警,多次在业务报错前提前介入处理;端口探测列表也成为日常巡检的第一入口。